结构化拆解
视觉大模型把原片逐镜拆成可用的结构化数据,而不是一堆描述文字。
- 逐镜提取站位、景别、动作、台词
- 自动识别承接方式(硬切 / 淡入淡出 / 叠化 / 匹配剪辑)
- 开场画面、连续表演、镜尾状态三段式记录
 下载客户端 ↗
把参考片拆开,变成可复刻的镜头。上传一段原片,视觉大模型结构化拆解成 角色、场景、物品与逐镜信息,再生成片段级重绘提示词—— 原片是参考,不是答案。
FEATURES · 核心能力
整个工具围绕一条原则设计:参考原片学结构,用自己的素材重新生成。细节都在这条原则之下。
视觉大模型把原片逐镜拆成可用的结构化数据,而不是一堆描述文字。
角色、场景、物品统一管理,每个资产都有候选图库,随时切换最合适的那张。
参考图只用于锁定长相与场景结构,镜头还原靠逐镜文字描述——这是复刻与照抄的分界线。
设定目标语言与作品风格,场景、外貌、服饰与画面内文字按目标国家重写。
服装颜色逐件写明并在跨镜头间做串色校验,以最高优先级注入提示词。
标准 API 通道与豆包管理器本机通道双线出片,哪个快用哪个。
INTERFACE · 真实界面
以下均为软件实际运行截图,未做任何修饰。
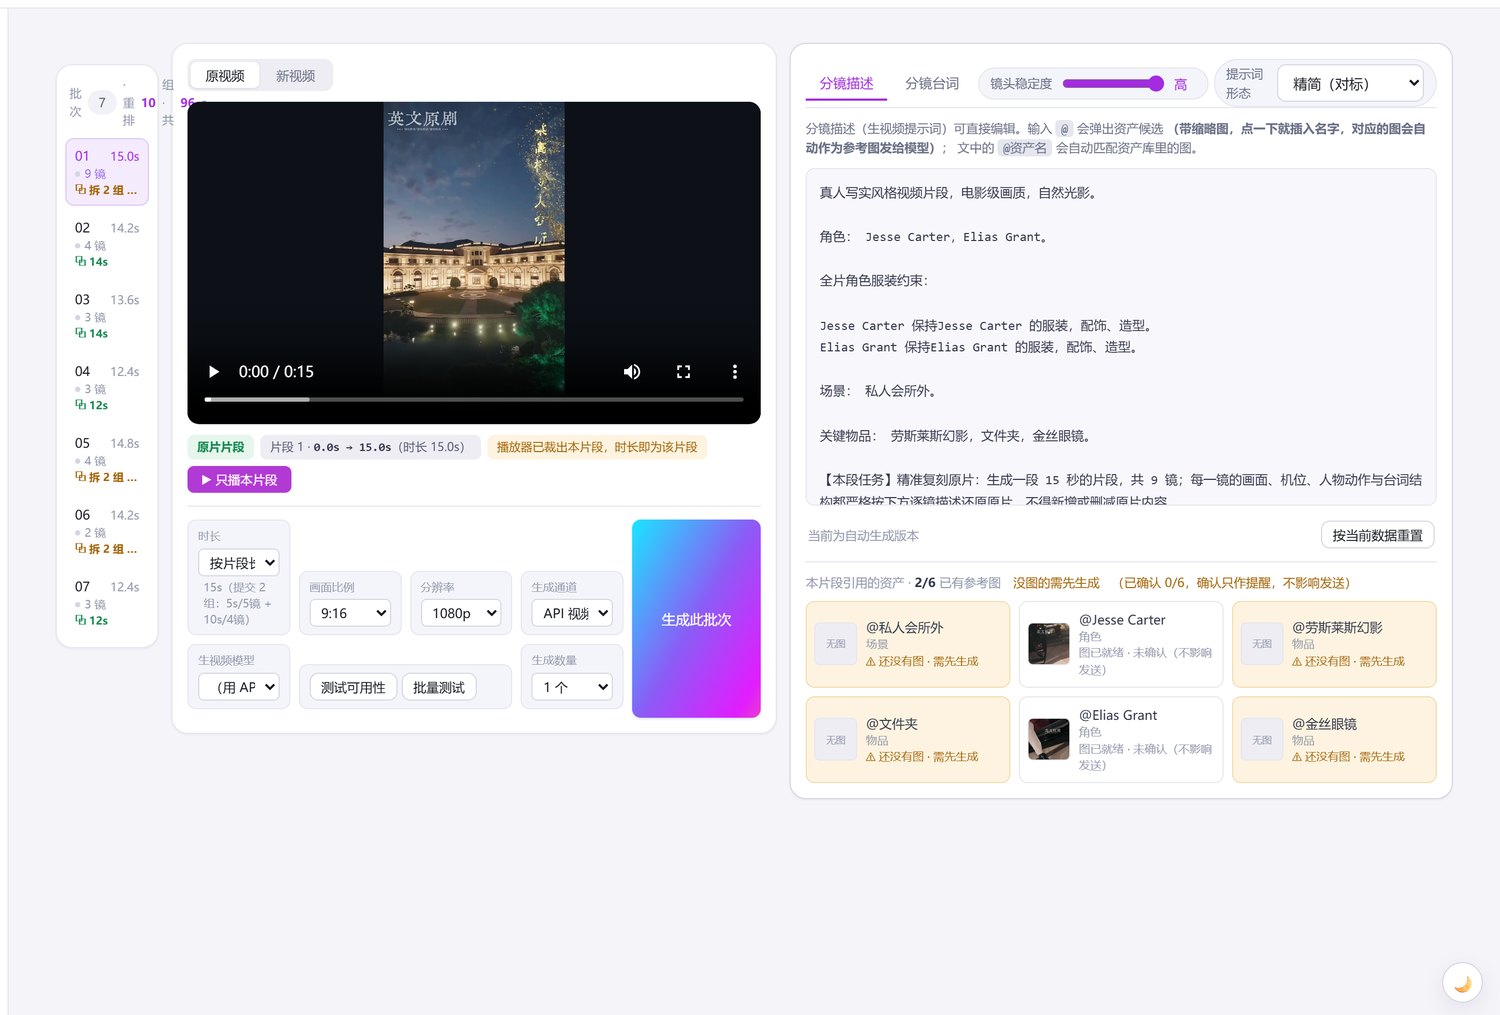
镜头列表在左,原片播放器在中,重绘指令与生图参数就在手边。 右侧实时显示当前镜头的分镜描述与用到的资产引用—— 哪张图、哪个角色,一眼就能核对。
每个片段独立设置时长、宽高比、分辨率、生成模型与生成数量, 改完就能立即「生成本批次」,不需要回到别处配置。
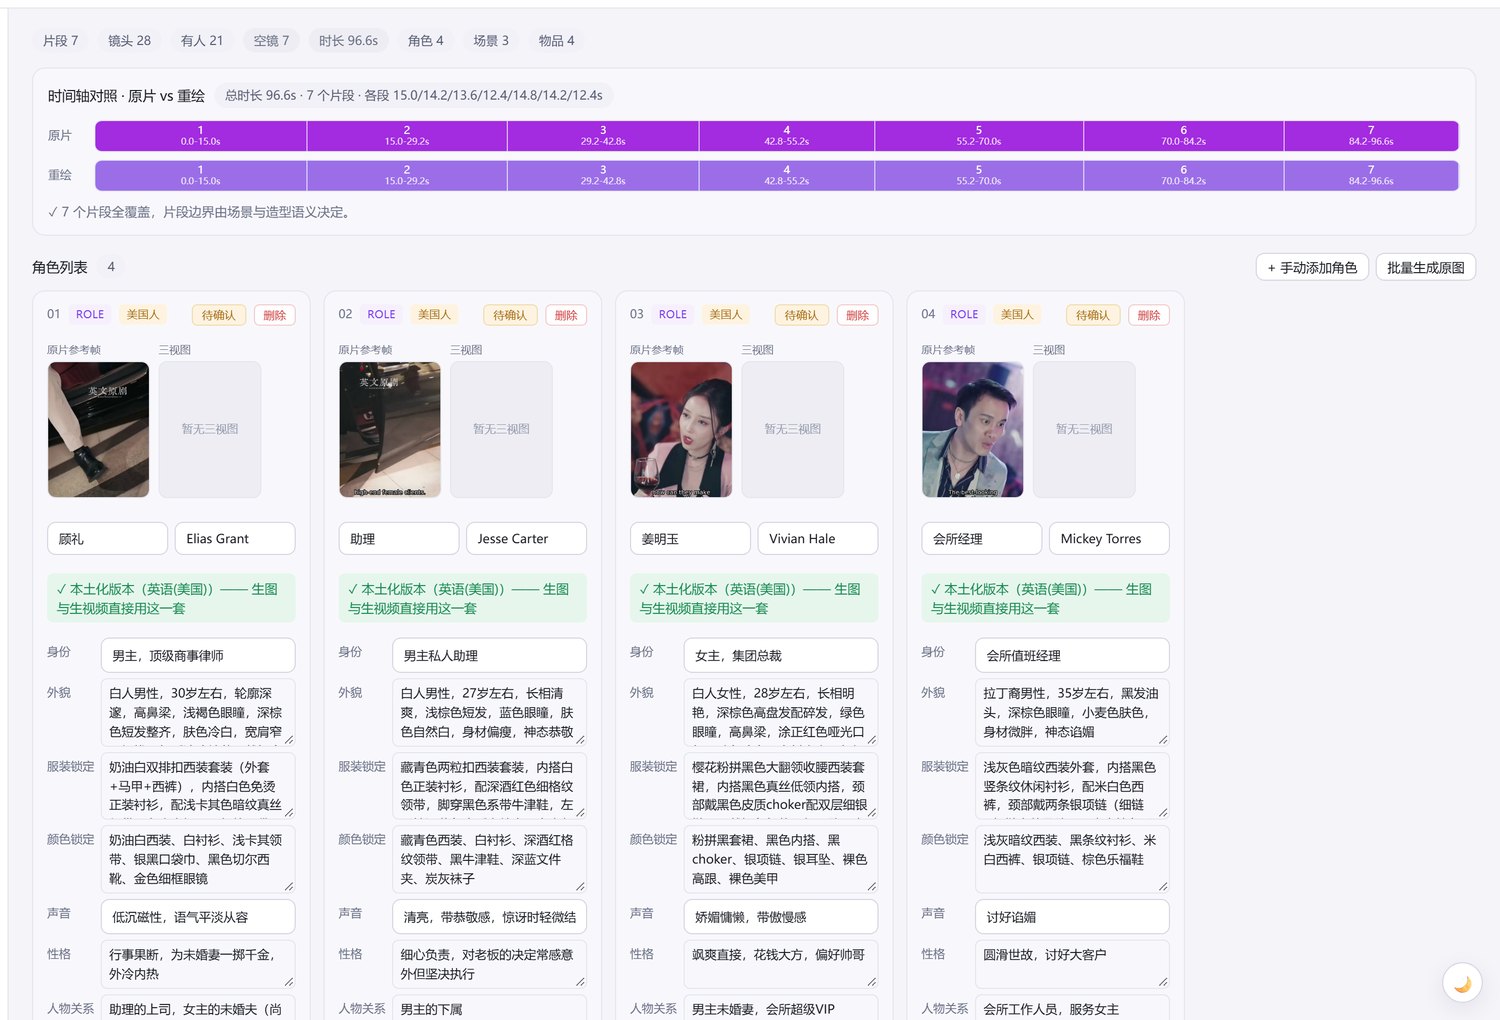
顶部是时间轴对照条,原片与重绘版本的镜头段落一一对应, 哪一段改过、哪一段漏了,一眼就能看出来。
下方是角色列表。每个人的身份、外貌、服装、性格、声音、人物关系都可编辑, 旁边就是原片参考帧与三视图位置—— 资产图在这里统一管理,下游提示词只读取"使用中"的那张。
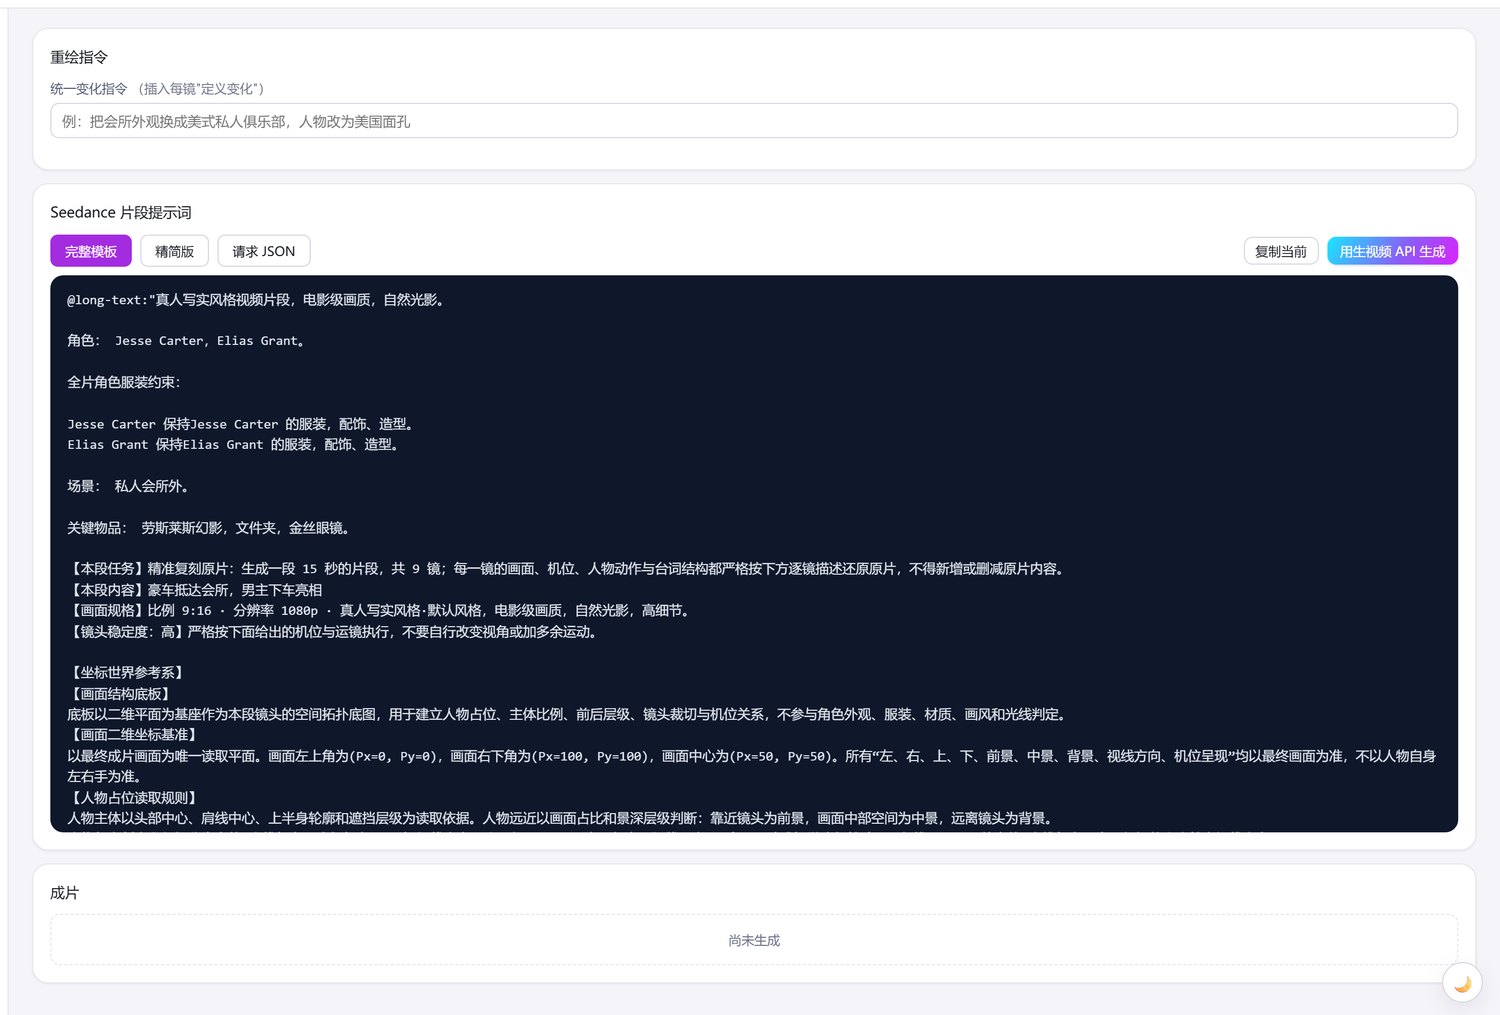
全局重绘指令写在顶部,用来约束整部片子的走向; 下面是每个片段的 Seedance 提示词,三种视图随时切换。
提示词里精确到镜头任务、画面构成、人物动作与台词指向, 末尾附上"精准复刻原片"的执行要求—— 这段文字直接就能复制出去用。
WORKFLOW · 四步流程
字段齐全时不会跑推理模型,缺项才自动补漏,效率优先。
拖入参考视频,设定目标语言、作品风格与复刻档位,自动检测镜头切换点。
角色、场景、物品清单逐项确认,生成三视图与场景图集并选定使用中的那张。
左原片、中提示词与台词、右生成结果,三栏对照逐镜打磨,可单独重生成。
按片段出图出片,提示词可整段复制或改写重生成,成片直接落到本地。
TUTORIAL · 视频教程
完整演示涅槃AI转绘的实际操作流程:从导入参考原片、结构化拆解资产,到分镜提示词逐镜打磨与成片导出,一段视频看完整个工作台怎么用。
视频加载失败?点此打开视频直链 ↗
手机观看建议横屏,点击播放按钮后旋转手机即可全屏播放
拖入参考视频后自动检测镜头切换点,角色、场景、物品逐项拆解成清单,并生成三视图与场景图集。
左原片、中提示词与台词、右生成结果三栏对照,逐镜打磨提示词,单镜不满意可单独重生成。
按片段出图出片,提示词可整段复制或改写重生成,成片直接落到本地目录。
SPECIFICATION · 规格参数
FAQ · 常见问题
原片只能看,转绘能改。工具把原片的镜头结构、人物关系、场景布局全部拆成数据与文字,你换一套自己的素材、换一种风格、换一种语言,重新生成一版属于自己的片子——结构照着学,内容全是自己的。
那样模型会像素级照抄原片,那叫视频转绘而不是重新生成。参考图只用来锁定"谁长什么样、场景什么结构",镜头层面的构图、站位、景别、光影、动作全部靠逐镜文字描述还原。
用标准 API 通道需要配置三套:分析模型(方舟)、生图模型、生视频模型。也可以走豆包管理器本机通道,此时不需要任何 API Key。密钥只存在本地服务端,不外传。
档位决定模型每秒抽多少帧分析。简单到超精共五档,越高还原度越准但成本也越高。量产默认选高度复刻,既有足够还原度,成本也可控。
项目数据在 %APPDATA%\视频重绘工作台\,在系统盘,重装会丢。提前备份整个目录即可;安装包重新下载安装,源码侧可重新打包。
单文件最大 2GB。分析时按 10 秒分桶切分镜头段落,原片永久保存在本机磁盘,刷新或中断都不会丢,重新打开继续。